Reinforcement Learning: Optimizing 0.6B Dense Models on TPU v7 via vLLM
·30 min read
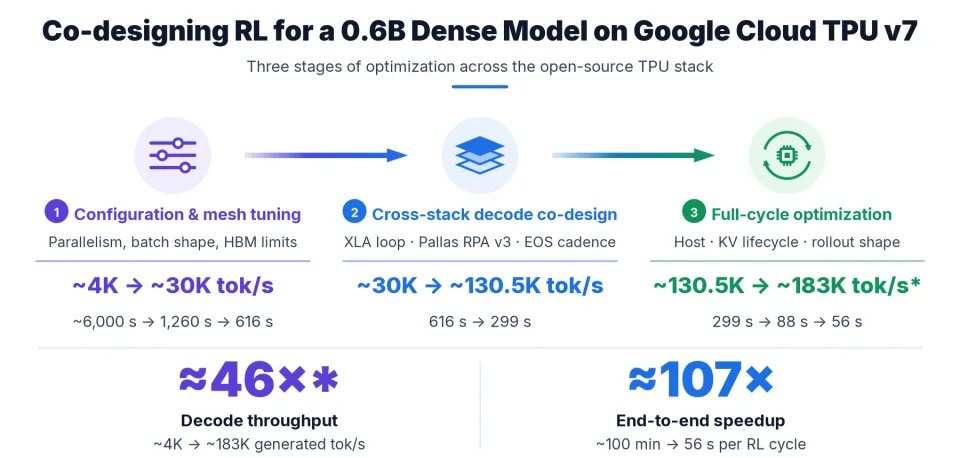
Co-designing RL for a Qwen3-0.6B dense policy on Google Cloud TPU v7 across vLLM, Tunix, MaxText, and Pallas, with a 107x end-to-end speedup from ~100 minutes to ~56 seconds per true-8K RL cycle.